Tvorba modelů pro přepis řeči v italštině – David Šafařík
David Šafařík
Bakalářská práce
Tvorba modelů pro přepis řeči v italštině
Creation of models for speech transcription in Italian
Anotace:
Tato bakalářská práce se zabývá tvorbou modelů pro přepis řeči v italštině. Rešerše této práce se zabývá popisem současného stavu systémů pro automatické rozpoznávání řeči (ASR). Automatické rozpoznávání řeči je nejprve popsáno obecně, následně se popis zaměřuje na modulární architekturu a end-to-end (E2E) architekturu systémů ASR. Následující kapitola je věnována popisu italštiny z obecného, gramatického …víceAbstract:
This bachelor thesis is concerned with the creation of models for speech transcription in the Italian language. The research part of this thesis describes the current state of systems for automatic speech recognition (ASR). It begins with a general description of ASR, after which the modular and end-to-end (E2E) architectures of ASR systems are described. The next chapter describes the Italian language …více
Jazyk práce: čeština
Datum vytvoření / odevzdání či podání práce: 16. 5. 2022
Obhajoba závěrečné práce
- Vedoucí: Ing. Petr Červa, Ph.D.
Citační záznam
Jak správně citovat práci
Šafařík, David. Tvorba modelů pro přepis řeči v italštině. Liberec, 2022. bakalářská práce (Bc.). Technická univerzita v Liberci. Fakulta mechatroniky, informatiky a mezioborových studií
Plný text práce
Obsah online archivu závěrečné práce
Zveřejněno v Theses:- světu
Jak jinak získat přístup k textu
Instituce archivující a zpřístupňující práci: Technická univerzita v Liberci, Fakulta mechatroniky, informatiky a mezioborových studií
Technická univerzita v Liberci
Fakulta mechatroniky, informatiky a mezioborových studiíBakalářský studijní program / obor:
Informační technologie / Inteligentní systémy
Práce na příbuzné téma
-
PARAMETRICKY EFEKTIVNÍ MODELY PRO AUTOMATICKÉ ROZPOZNÁVÁNÍ ŘEČI A JAZYKA
Amrutha Prasad -
PARAMETRICKY EFEKTIVNÍ MODELY PRO AUTOMATICKÉ ROZPOZNÁVÁNÍ ŘEČI A JAZYKA
Amrutha Prasad -
Automatické rozpoznávání šeptavé řeči
Daniel CAJTHAML -
Automatické generování interpunkce v systémech rozpoznávání řeči
Martin Poláček -
Efektivní trénování neuronových sítí pro automatické rozpoznávání řeči
Matej Horník -
Evaluace a adaptace open-source systémů pro automatické rozpoznávání řeči s přiřazením identity mluvčího
Daniel Svatopluk Bohata -
Řečové velké jazykové modely pro automatické rozpoznávání řeči více mluvčích
Martin Vaculík -
PARAMETRICKY EFEKTIVNÍ MODELY PRO AUTOMATICKÉ ROZPOZNÁVÁNÍ ŘEČI A JAZYKA
Amrutha Prasad
Název
Vložil
Vloženo
Práva
Theses 7lfu4m 7lfu4m/2
16. 5. 2022
Složky
Soubory
-
Přidání souboru
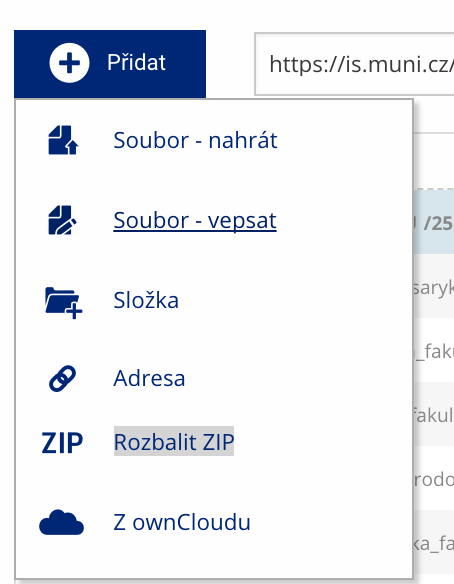 Soubor nebo složku lze nahrát pomocí tlačítka Přidat.
-
Další operace se soubory
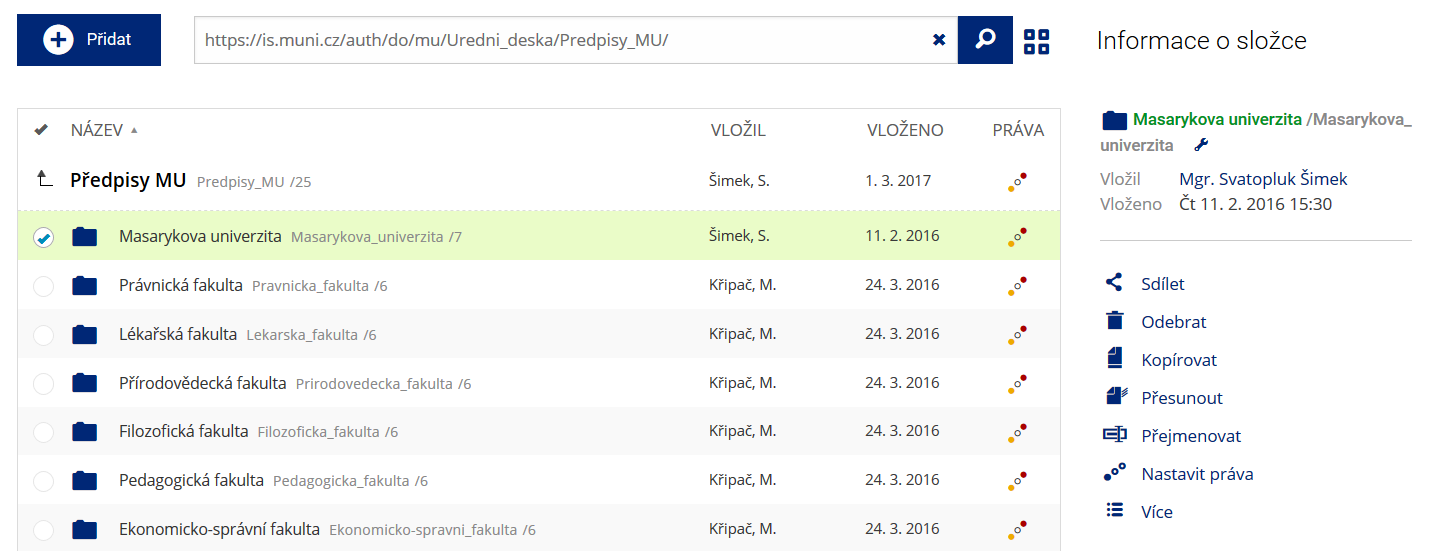 Podrobnosti lze zjistit označením příslušného řádku.
-
Pohled pro experty
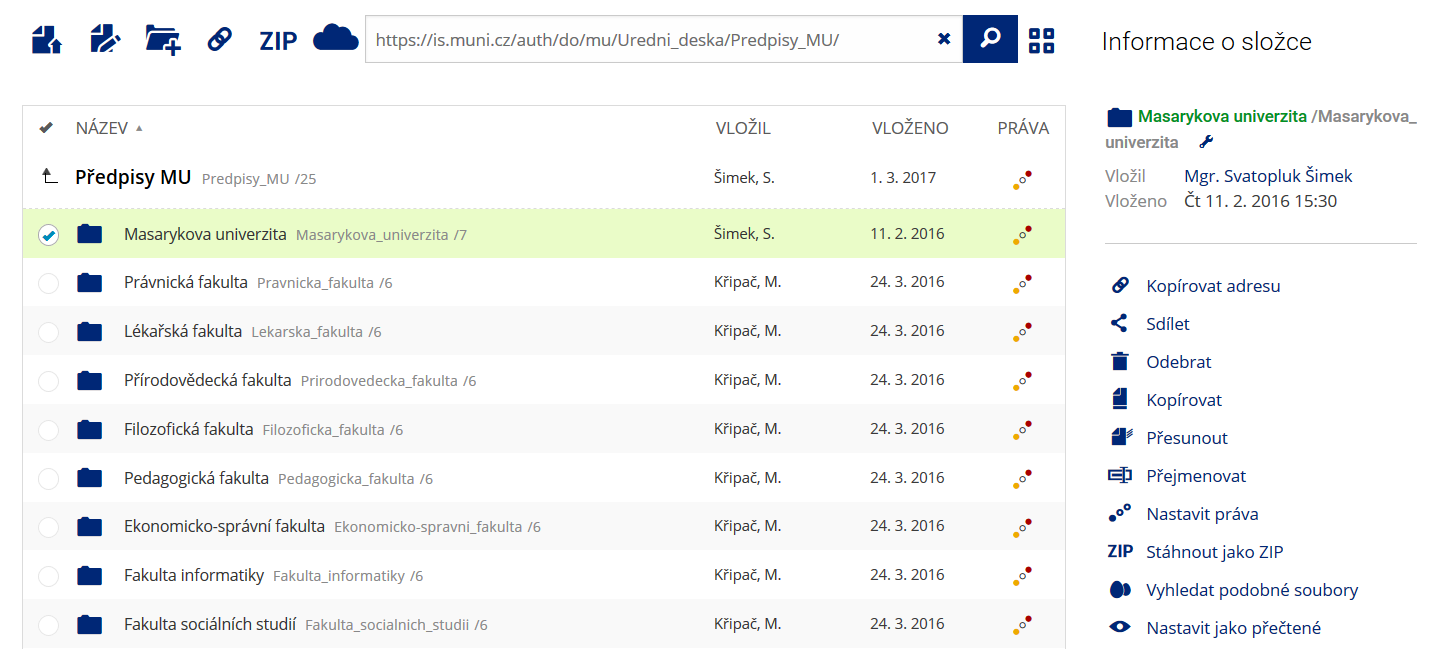 Pro častou práci je možné zvolit režim Více možností.
-
Vyhledávání souborů
 Vyhledávaný výraz můžete zadat přímo do adresního řádku.
-
Rychlý přístup k souborům
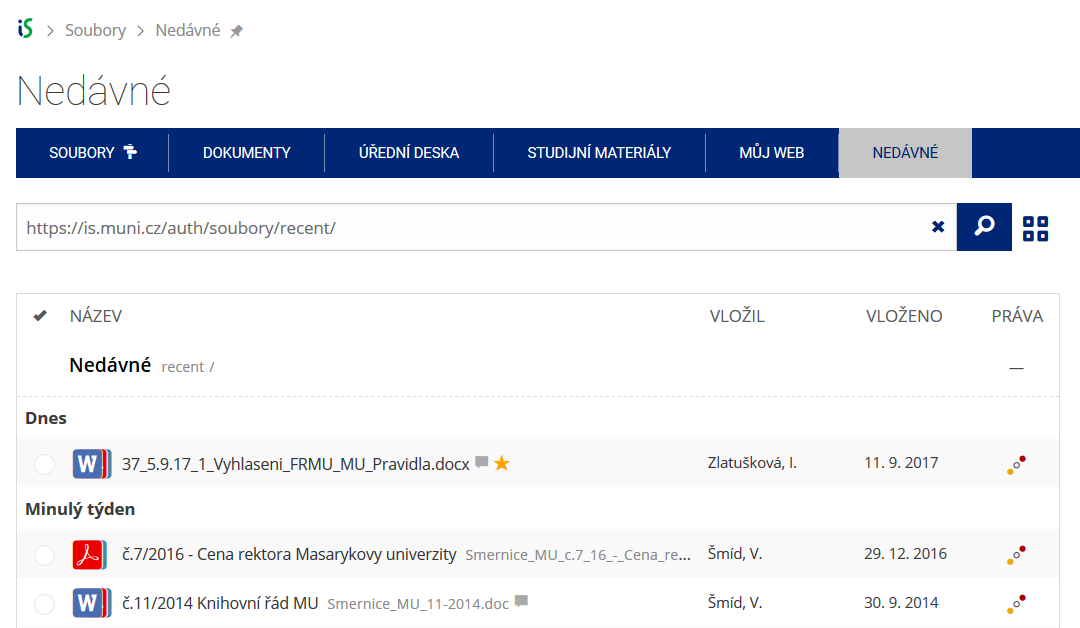 Pomocí funkce Nedávné je možné se rychle vrátit k právě prohlíženým souborům. Oblíbené soubory je také možné označit Hvězdičkou.